2.10.1 ROC曲线与AUC
手里有一个检验数值或模型评分时,常会遇到这些问题:
- 血液标志物能否把有感染和无感染的受检者区分开?
- 影像评分降低判阳阈值后,能多检出多少病变,又会多报多少假阳性?
- 再入院风险模型在留出的评价数据上,能否把再入院者排在前面?
- 两个筛查评分的敏感度和假阳性率怎样随阈值变化?
受试者工作特征曲线(ROC 曲线)把不同阈值下的敏感度与假阳性率画在同一张图上。曲线下面积(AUC)概括评分的排序能力。学完后,你应能由一张人数表读出曲线上的一个点、解释 AUC,并识别它不能回答的问题。
2.10.1.1 一个阈值对应一个点
先规定哪一类是阳性,以及评分是否越高越倾向阳性。给定阈值,将评分大于或等于该值的记录判为阳性。敏感度是实际阳性中被判阳性的比例;假阳性率是实际阴性中被误判为阳性的比例,等于 1 减特异度。
降低阈值通常能检出更多阳性,同时也可能增加假阳性。把所有不同评分依次当成阈值,同分记录一起进入,得到一连串坐标:横轴是假阳性率,纵轴是敏感度。曲线越靠近左上方,表示能在较低假阳性率下获得较高敏感度。
AUC 也可以这样理解:从评价数据各取一条阳性和阴性记录,阳性分数更高记 1,分数相同记半次,平均得分就是 AUC。这解释了为什么 AUC 衡量排序,即使把分数改成保留原排序的严格单调递增变换,AUC 也不变。Hanley 与 McNeil给出了这一解读。
2.10.1.2 模型在训练集拟合,曲线在留出集画
用 MASS::biopsy 的乳腺肿物细胞学记录。用细胞团厚度 V1 和裸核 V6 的评分区分良性和恶性,恶性为阳性。剔除 16 条所用评分缺失的记录后,683 条完整记录中,476 条拟合模型,207 条用于评价。
原数据的样本编号 ID 不唯一,所以按编号而非按行抽取训练集,让同一编号不跨集合。模型公式在划分前指定,只用训练集拟合;评价集只用于计算曲线和 AUC。0.50 是用来展示坐标的阈值,并非从评价集挑出来的“最佳值”。想先了解如何取得概率,可读2.3.1 Logistic回归。
if (!requireNamespace("MASS", quietly = TRUE)) {
  utils::install.packages("MASS", repos = "https://cloud.r-project.org")
}
utils::data("biopsy", package = "MASS")

# 仅纳入这两个评分和结局均完整的记录;不插补,也不用全样本学习变换。
biopsy_complete <- biopsy[stats::complete.cases(biopsy[c("V1", "V6", "class")]), ]
biopsy_complete$malignant <- as.integer(biopsy_complete$class == "malignant")
train_fraction <- 0.70 # 按样本编号抽取 70%(取整)供拟合;其余编号仅评价。
example_threshold <- 0.50 # 仅标出一个预设阈值;不根据评价结果选择阈值。
set.seed(2718, kind = "Mersenne-Twister", sample.kind = "Rejection")
sample_ids <- unique(biopsy_complete$ID)
train_ids <- sample(sample_ids, floor(train_fraction * length(sample_ids)))
in_training <- biopsy_complete$ID %in% train_ids
biopsy_train <- biopsy_complete[in_training, ]
biopsy_evaluation <- biopsy_complete[!in_training, ]

# 只在训练集拟合固定公式;response 返回恶性(malignant = 1)的模型概率。
model_fit <- stats::glm(
  malignant ~ V1 + V6, data = biopsy_train,
  family = stats::binomial(link = "logit"), na.action = stats::na.fail
)
scores <- stats::predict(model_fit, newdata = biopsy_evaluation, type = "response")
positive <- biopsy_evaluation$malignant == 1L

# 逐个降低阈值,同分一起处理;累积计数除以对应的真实类别人数。
score_order <- order(scores, decreasing = TRUE)
sorted_scores <- scores[score_order]
sorted_positive <- positive[score_order]
last_at_score <- !duplicated(sorted_scores, fromLast = TRUE)
false_positive_rate <- c(0, cumsum(!sorted_positive)[last_at_score] / sum(!positive))
sensitivity <- c(0, cumsum(sorted_positive)[last_at_score] / sum(positive))
left <- seq_len(length(sensitivity) - 1L)
auc <- sum(diff(false_positive_rate) *
  (sensitivity[left] + sensitivity[left + 1L]) / 2)

# 该阈值只是曲线上的一个点;计算两类记录各自被判阳性的比例。
predicted_positive <- scores >= example_threshold
operating_fpr <- mean(predicted_positive[!positive])
operating_tpr <- mean(predicted_positive[positive])
print(table(set = ifelse(in_training, "train", "evaluation"), class = biopsy_complete$class))
print(table(observed = biopsy_evaluation$class, called_positive = predicted_positive))
print(c(AUC = auc, FPR = operating_fpr, sensitivity = operating_tpr))

graphics::plot(
  false_positive_rate, sensitivity, type = "l",
  xlim = c(0, 1), ylim = c(0, 1), las = 1, col = "#176181", lwd = 3,
  xlab = "False positive rate (1 - specificity)", ylab = "Sensitivity"
)
graphics::segments(0, 0, 1, 1, lty = 2, col = "gray55", lwd = 1.4)
graphics::points(operating_fpr, operating_tpr, pch = 19, col = "#B14916", cex = 1.3)
2.10.1.3 曲线上的橙点说明什么?
| R 输出 | 统计含义 | 本例怎样读 |
|---|---|---|
evaluation、train |
按数据角色列出的良性和恶性记录数 | 留出的 207 条评价记录含良性 140 条、恶性 67 条 |
observed × called_positive |
真实类别与阈值下判定的交叉表 | 恶性中判阳 63 条;良性中误判阳性 5 条 |
sensitivity、FPR |
敏感度和假阳性率 | 在 0.50 阈值,敏感度 ,假阳性率 |
AUC |
按所有阈值计算的经验 ROC 曲线面积 | 0.9912 表示在这批评价记录中,恶性记录的评分通常排在良性记录之前;同分按半次计入 |
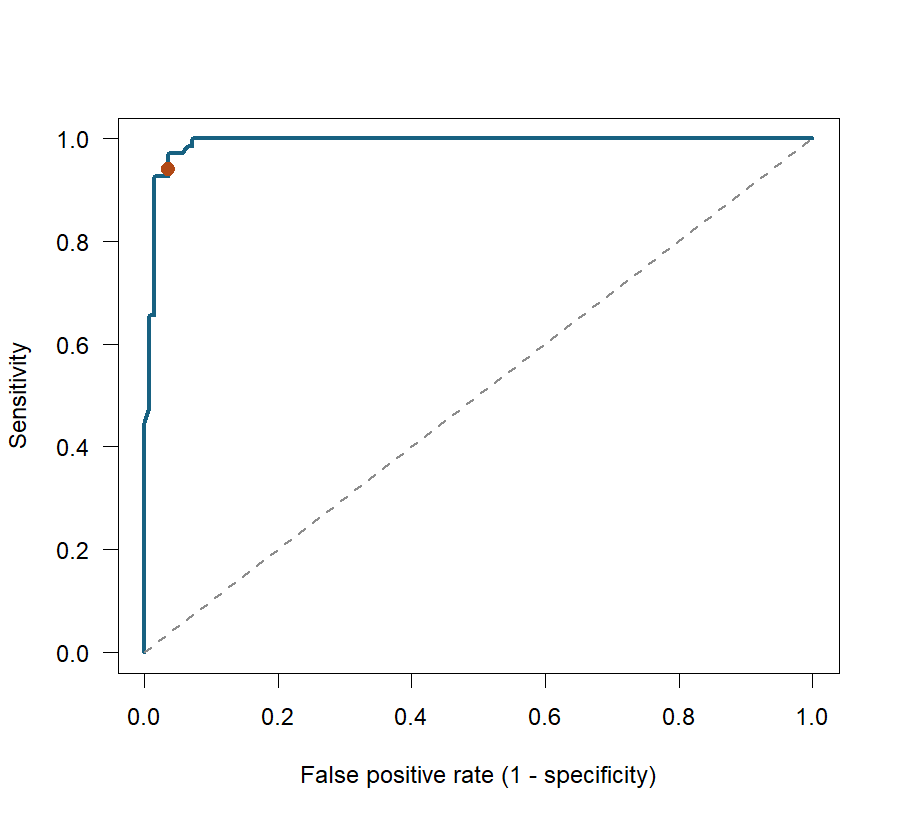
这张图由上述模型的留出集分数计算。蓝线汇集所有阈值;橙点只是其中一个选择;灰色对角线表示敏感度与假阳性率相等的参考。
较高 AUC 不代表预测概率和实际风险一致,也不能说明某个阈值适合临床。应用时还要检查校准、考虑漏诊和误报的后果,并在目标人群中验证。本例是同一数据来源的一次内部留出评价;AUC 按记录计算,不能据此宣称患者层级或外部验证已完成。
已有评价集分数时,可直接使用同编号代码碎片计算 AUC 和阈值坐标,不需要重拟合模型。